
Ceph Status Details, OSDs und Placement Groups
Der Bereich Cluster Status zeigt detaillierte Ceph-Informationen, die für Betrieb und Fehlersuche wichtig sind. Die eEKAS R8 Oberfläche enthält Tabs für Ceph Status, Monitors, Managers, MDS, Objects / PGs und MON/MGR Placement.
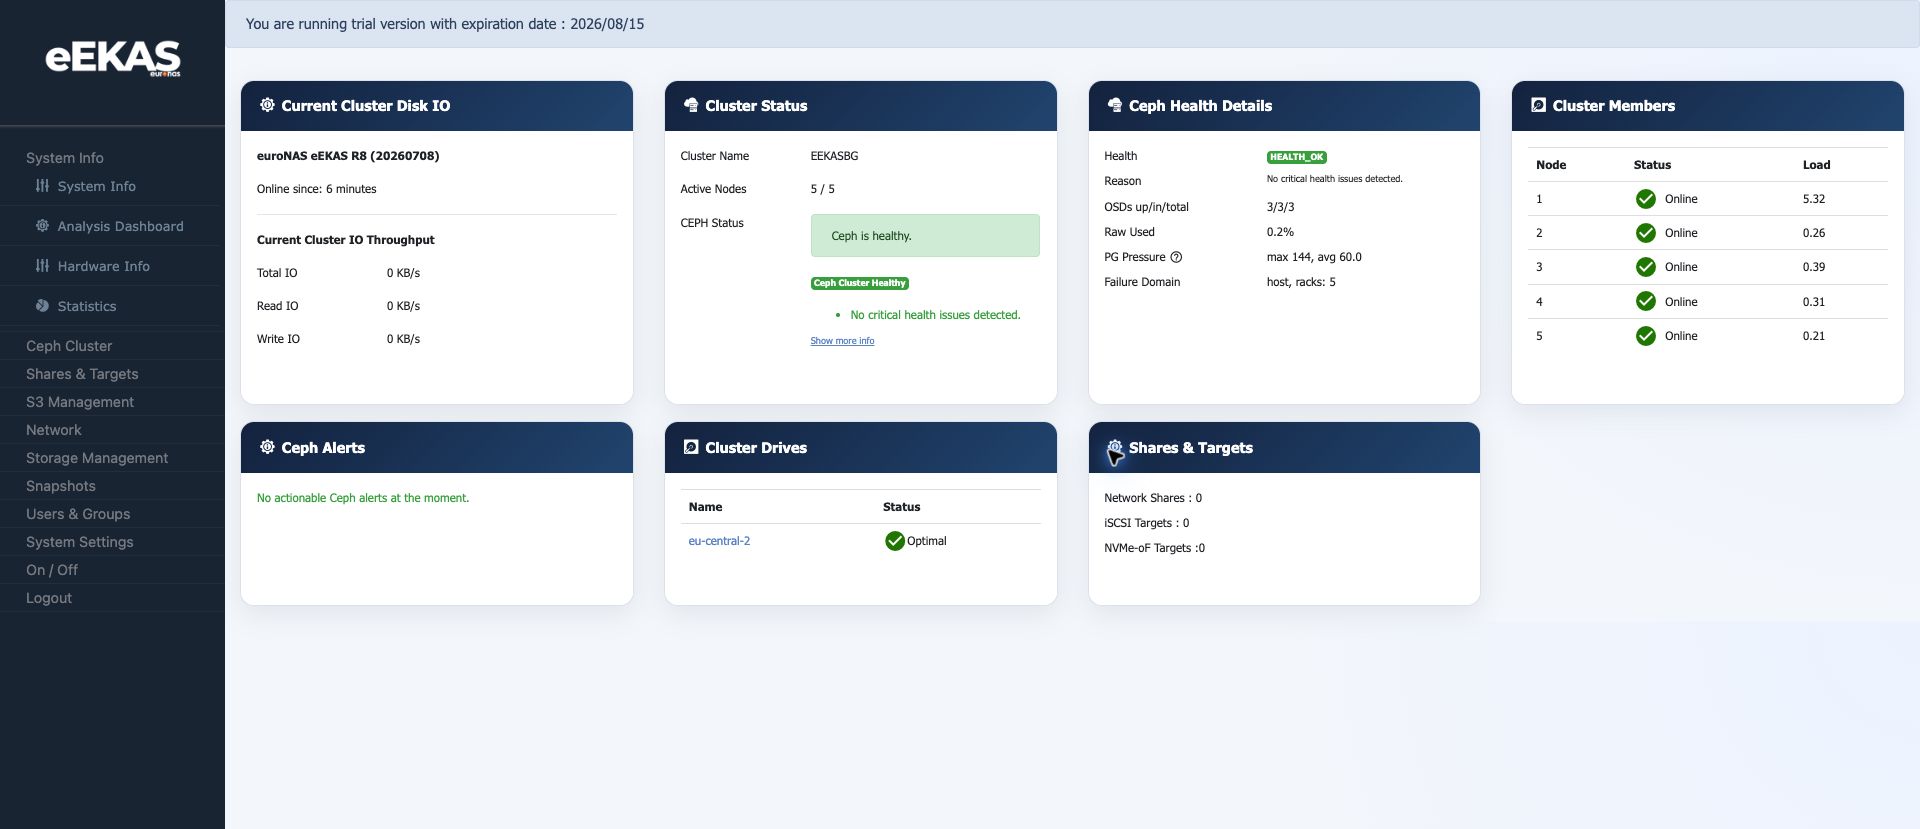
Wichtige Health-Felder
| Feld | Bedeutung |
|---|---|
| Health | Gesamtzustand von Ceph. HEALTH_OK bedeutet, dass aktuell kein kritisches Health-Problem gemeldet wird. |
| Reason | Kurze Erklärung des aktuellen Health-Zustands. |
| OSDs up/in/total | Zeigt, wie viele OSDs laufen, im Cluster sind und insgesamt bekannt sind. |
| Raw Used | Prozentual belegte Rohkapazität. |
| PG Pressure | Indikator für Placement-Group-Druck. Das Dashboard kann Maximum und Durchschnitt anzeigen. |
| Failure Domain | Ausfallgrenze für Datenplatzierung, zum Beispiel host. |
OSDs interpretieren
OSDs speichern die Objektdaten im Cluster. Ein gesunder Produktivzustand erfordert normalerweise, dass alle erwarteten OSDs sowohl up als auch in sind. Wenn ein OSD down oder out ist, kann der Cluster eventuell weiter Daten bereitstellen, aber Redundanz und Recovery-Status müssen geprüft werden.
Placement Groups
Placement Groups verteilen Daten über OSDs. Die Ansicht Objects / PGs hilft dabei, Objektverteilung, PG-Anzahl und Druck zu verstehen. Hoher oder ungleichmäßiger PG Pressure kann auf Kapazitäts-, Placement- oder Recovery-Themen hinweisen.
Empfohlener Ablauf bei Fehlersuche
- Mit der Dashboard-Health-Zusammenfassung beginnen.
- Cluster Status öffnen und Ceph Status prüfen.
- OSDs up/in/total und Raw Used prüfen.
- Objects / PGs prüfen, wenn Performance, Balancing oder Recovery auffällig sind.
- Health-Zustand und genaue Warnmeldung dokumentieren, bevor Maßnahmen durchgeführt werden.
Gute Praxis
Keine großen Konfigurationsänderungen während eines ungesunden Zustands durchführen, außer die Änderung ist Teil des Recovery-Plans. Zuerst den aktuellen Zustand dokumentieren und dann entscheiden, ob Node, Disk, Netzwerk, Kapazität oder Placement betroffen ist.