
Ceph Status Details, OSDs und Placement Groups
DerDie BereichTabs ClusterCeph Status zeigtund Objects / PGs zeigen detaillierte Ceph-Health-Informationen, die für Betrieb und Fehlersuche wichtig sind. Die eEKAS R8 Oberfläche enthält Tabs für Ceph Status, Monitors, Managers, MDS, Objects / PGs und MON/MGR Placement.
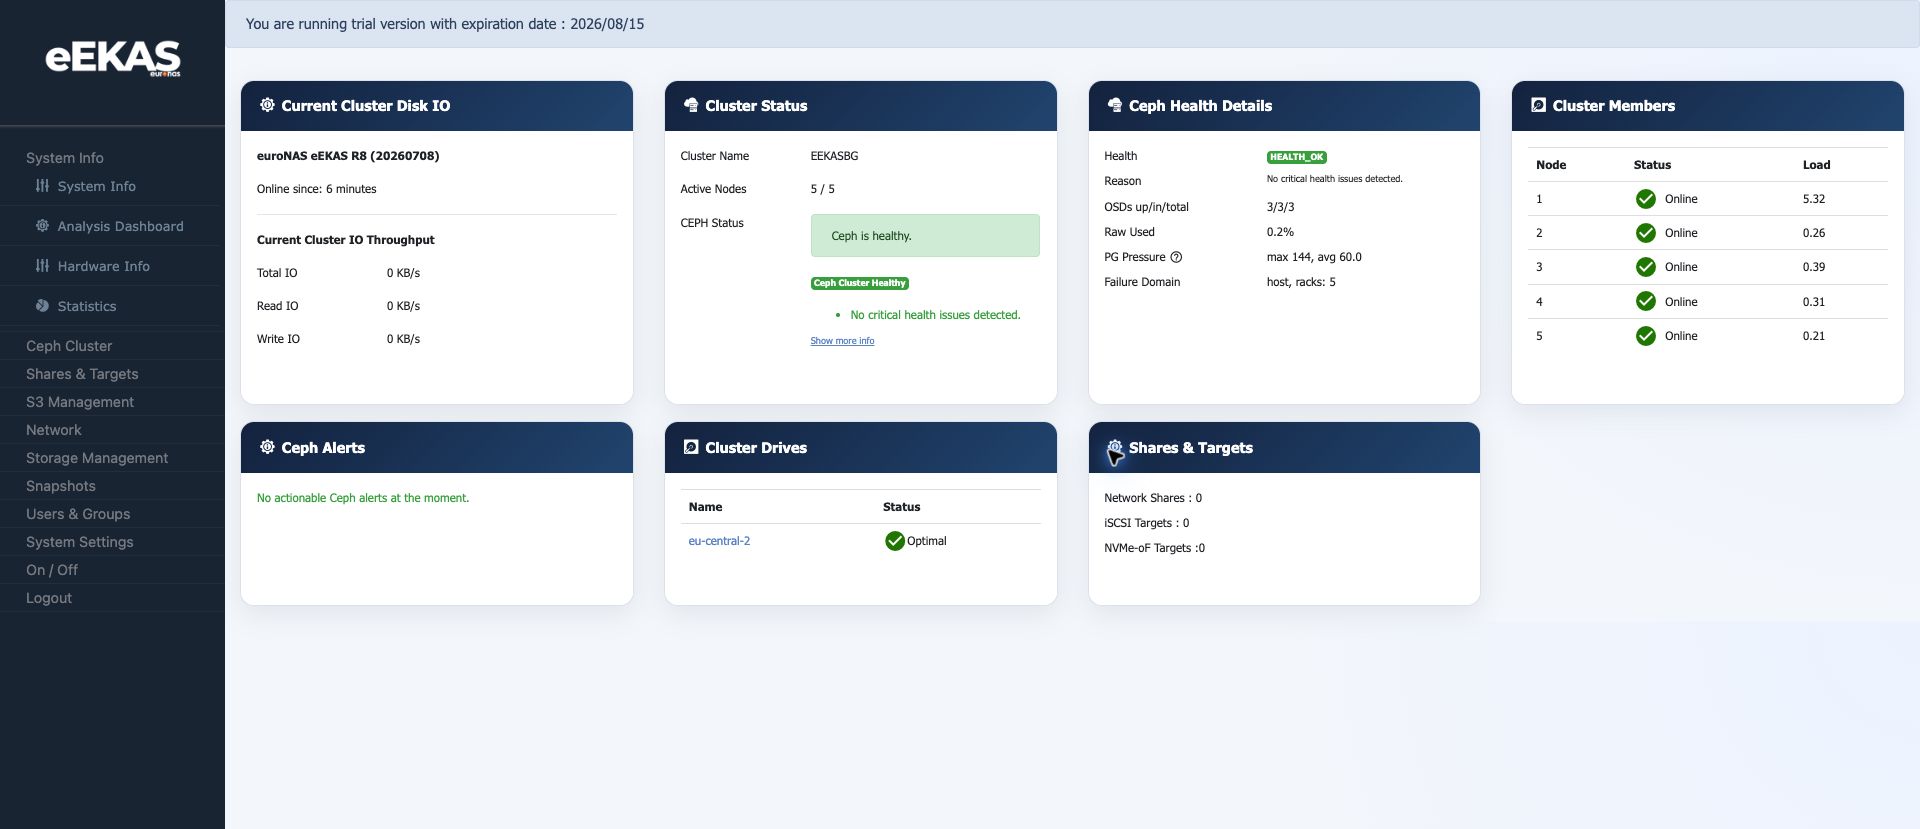

Wichtige Health-Felder
| Feld | Bedeutung |
|---|---|
| Health Status | Gesamtzustand von Ceph. |
| PG |
|
OSDs
Im interpretierenTestcluster
OSDsmeldete speichernCeph dieeinen Objektdatengesunden imZustand, Cluster.Total EinMONs gesunderwar Produktivzustand erfordert normalerweise, dass alle erwarteten OSDs sowohl up als auch in sind. Wenn ein OSD down oder out ist, kann5, der Clusteraktive eventuellManager weiterwar Daten bereitstellen, aber RedundanzEEKASBG-1.ynuwsd und Recovery-StatusPG müssenStates geprüftzeigte werden.active+clean: 180.
Objects und Placement Groups
Placement
Der verteilen Daten über OSDs. Die AnsichtTab Objects / PGs hilftzeigt dabei,objektbezogene Objektverteilung,Risikoindikatoren.
| Feld | Gesunde Bedeutung |
|---|---|
| Degraded Objects | 0 bedeutet, dass aktuell keine Objekte mit fehlender erwarteter Redundanz gemeldet werden. |
| Misplaced Objects | 0 bedeutet, dass die Datenplatzierung der erwarteten CRUSH-Platzierung entspricht. |
| Unfound Objects | 0 bedeutet, dass keine Objekte auf allen bekannten OSDs fehlen. |
| PG States | active+clean bedeutet, dass Placement Groups aktiv und |
Empfohlener Ablauf bei Fehlersuche
- Mit
derdemDashboard-Health-ZusammenfassungTab Cluster Status beginnen. ClusterCeph Status öffnen undCephHealthStatusStatus,prüfen.Total OSDsMONs,up/in/totalActive MGR undRawPGUsedStates prüfen.- Objects / PGs
prüfen,öffnenwennundPerformance,degraded,BalancingmisplacedoderundRecoveryunfoundauffälligobjectssind.prüfen. Health-ZustandExakteund genaue WarnmeldungWerte dokumentieren, bevor Maßnahmen durchgeführt werden.
Gute Praxis
Gute aktuellenPraxis
Ein gesunder Zustand dokumentierensollte 0 degraded, 0 misplaced und dann0 entscheiden,unfound obobjects Node,zeigen. Disk,Jeder Netzwerk,Wert Kapazitätungleich 0 sollte geprüft werden, bevor der Dienst an Benutzer oder PlacementKunden betroffenübergeben ist.wird.