
System-Überwachung & Analyse
Mit den eEVOS-Monitoringfunktionen überwachen Sie einzelne Systeme und Cluster im laufenden Betrieb. Für tägliche Kontrollen stehen die integrierten Dashboards zur Verfügung. Prometheus, REST API und Ansible eignen sich für detaillierte Abfragen und die zentrale Überwachung mehrerer Installationen.
Monitoringmöglichkeiten im Überblick
| Methode | Geeignet für | Zugriff |
|---|---|---|
| eEVOS-Dashboards | Tägliche Kontrolle und Diagramme | Normale GUI-Anmeldung |
| Prometheus | Metriken, Kapazitätsanalyse und PromQL | https://<eevos-adresse>/prometheus/ nach GUI-Anmeldung |
| REST API | Strukturierte Zustands-, Inventar- und Jobdaten | API-Schlüssel über https://<eevos-adresse>:18443/api/v1/ |
| Ansible | Wiederholbare Prüfungen auf mehreren Systemen | Separater Control-Node über SSH oder REST API |
| Alarme | Proaktive Meldung von Dienst- und Kapazitätsproblemen | Konfigurierter Benachrichtigungskanal |
Integrierte Webüberwachung
- Melden Sie sich an der eEVOS-Administrationsoberfläche an.
- Öffnen Sie Statistics.
- Wählen Sie IO Stats, VM Statistics oder Ceph Stats.
- Stellen Sie den Zeitraum ein und vergleichen Sie alle Cluster-Knoten.
- Untersuchen Sie dauerhaft hohe Werte, deutliche Abweichungen, fehlende Messreihen und unerwartete Nullwerte.
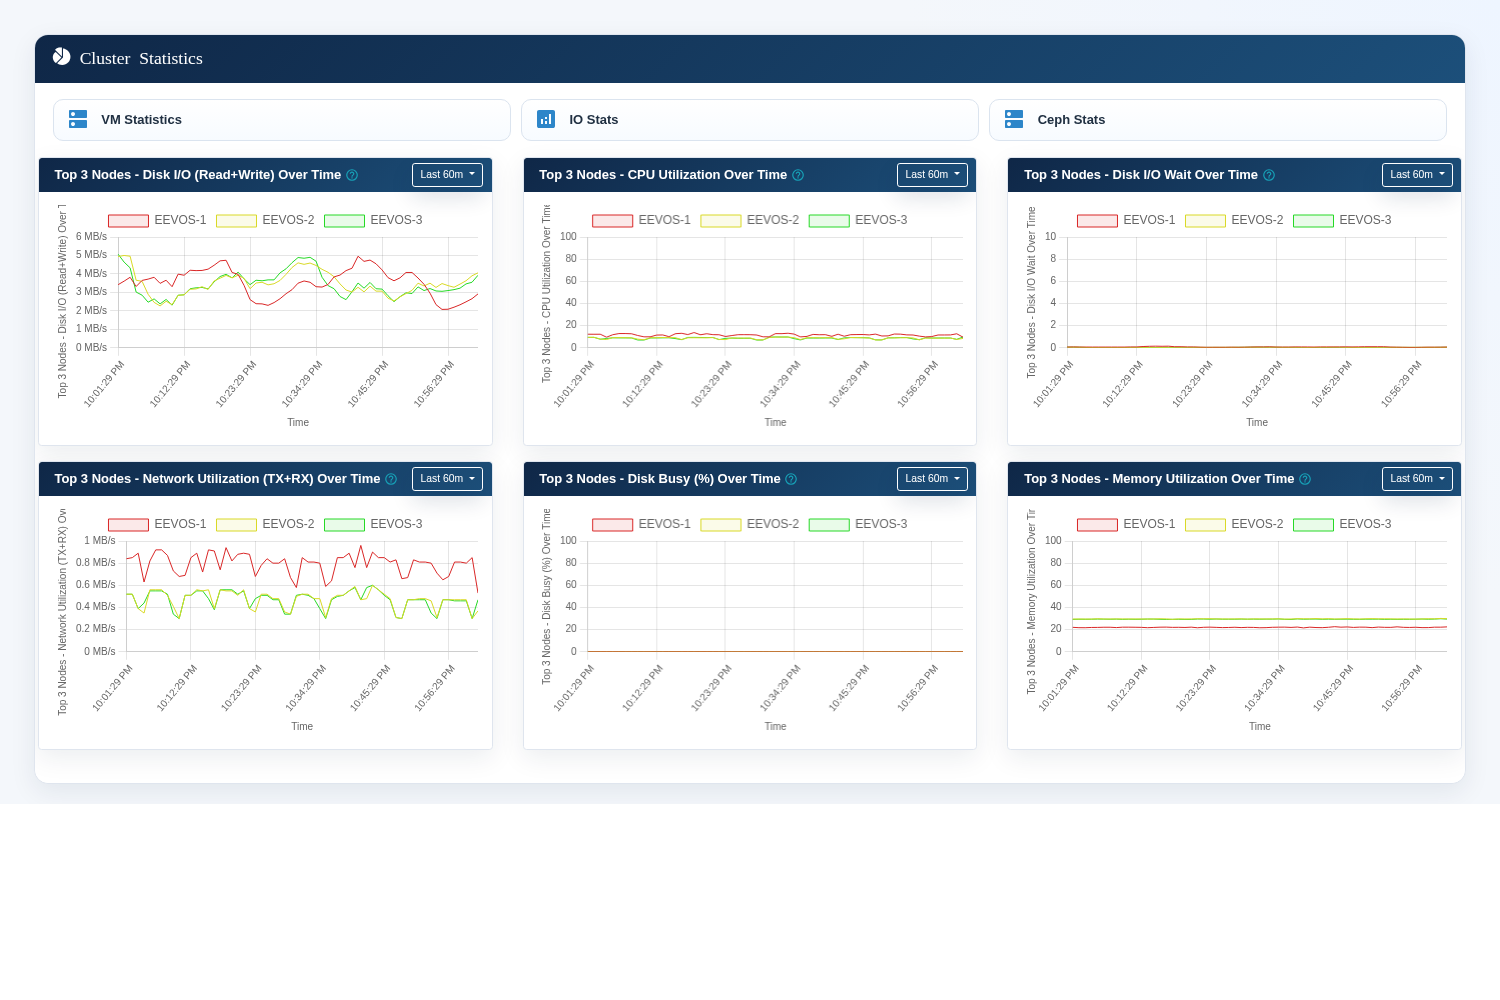
Das System-Dashboard bietet einen schnellen Überblick über Zustand und Auslastung.
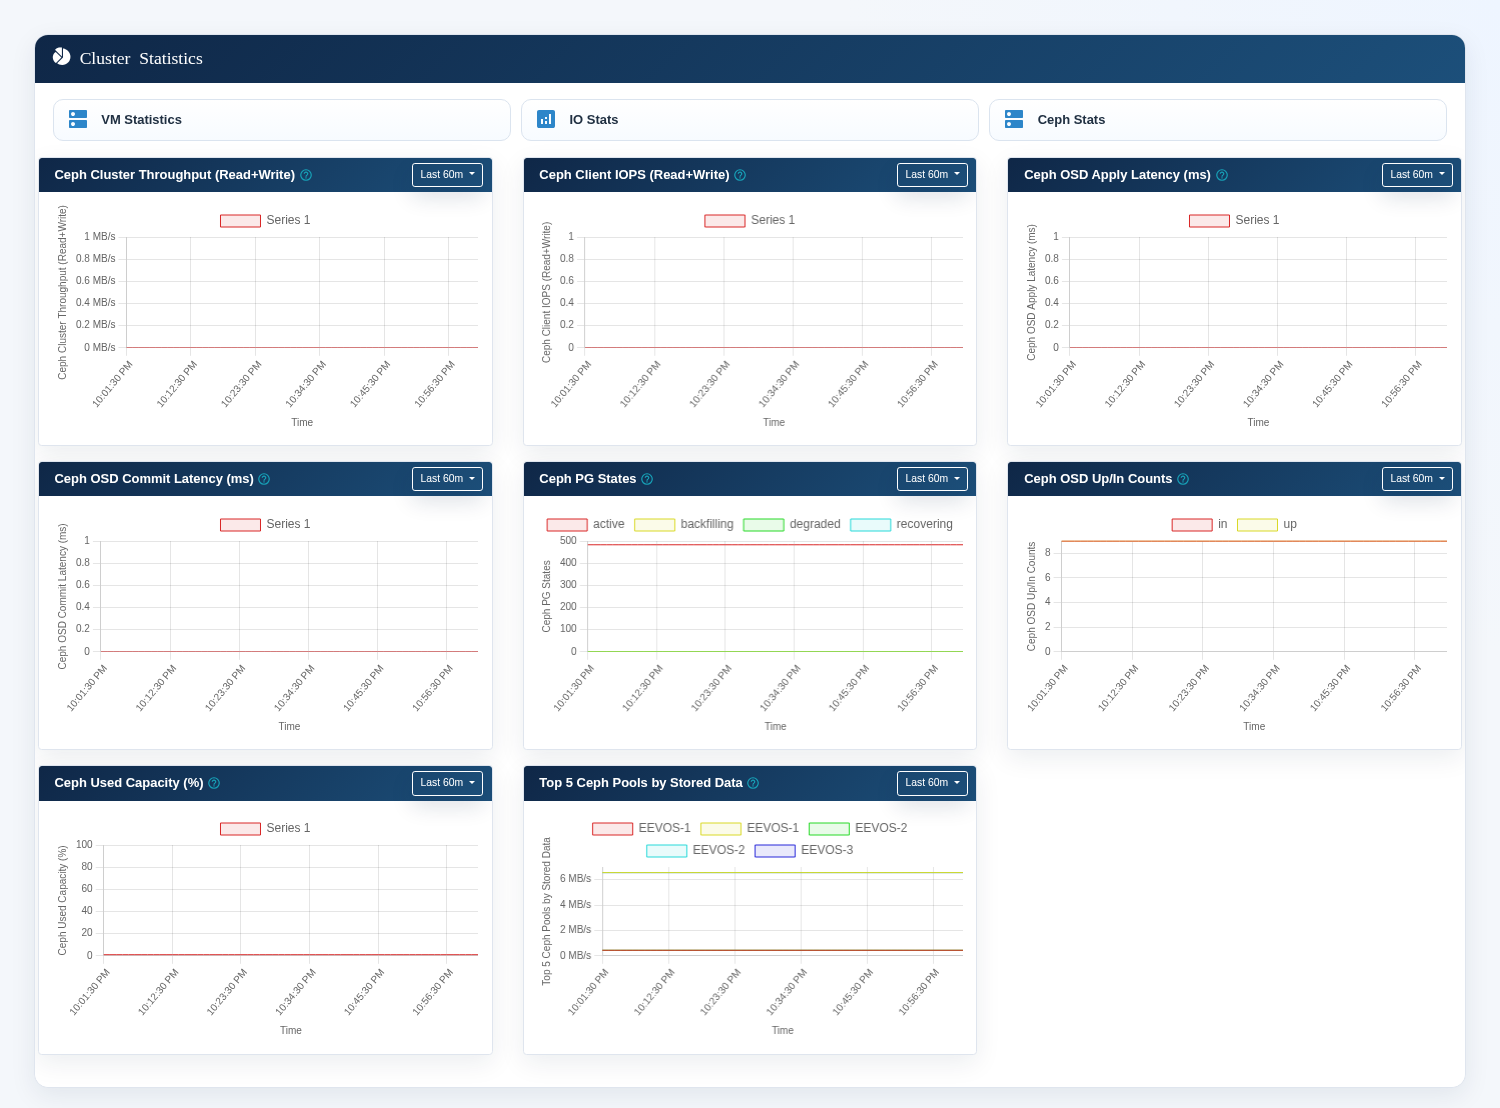
| Bereich | Darauf sollten Sie achten |
|---|---|
| CPU und Load | Dauerhafte Auslastung, plötzliche Änderungen oder einen Knoten, der stärker belastet ist. |
| Arbeitsspeicher | Wenig verfügbaren Speicher, steigenden Verbrauch oder Unterschiede zwischen Knoten. |
| Datenträger und Netzwerk | Hohe I/O-Wartezeit, dauerhaft ausgelastete Verbindungen oder inaktive Schnittstellen. |
| Virtuelle Maschinen | CPU-, Speicher-, Block-I/O- und Netzwerkverhalten einzelner VMs. |
| Ceph | OSDs, die nicht up/in sind, degradierte Placement Groups, Recovery, Latenz und Kapazität. |
Prometheus verwenden
Prometheus sammelt Zeitreihendaten der System-, VM- und Ceph-Exporter. Öffnen Sie Prometheus ausschließlich über den eEVOS-Proxy. Der lokale Prometheus-Port sollte nicht direkt in ungeschützte Netze veröffentlicht werden.
- Melden Sie sich an der eEVOS-Oberfläche an.
- Öffnen Sie im selben Browser
https://<eevos-adresse>/prometheus/. - Verwenden Sie Query für Abfragen, Alerts für Alarme und Status → Targets für den Exporter-Zustand.
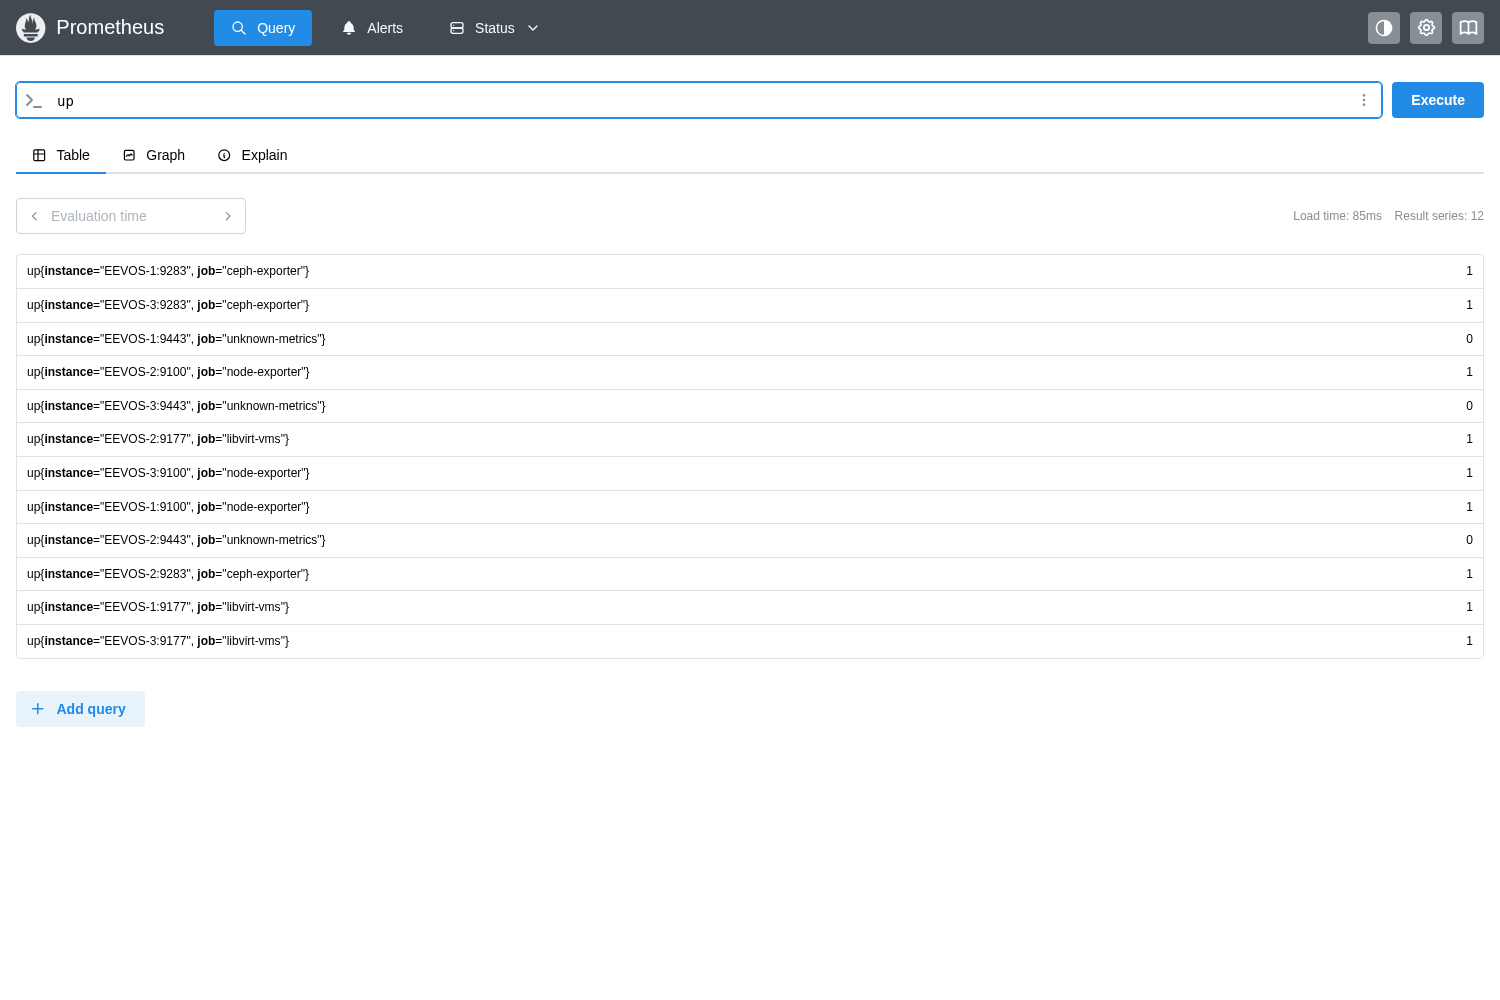
Nützliche Prometheus-Abfragen
| Zweck | PromQL |
|---|---|
| Erreichbarkeit aller Exporter | up |
| Systemlast | node_load1 |
| Verfügbarer Speicher in Prozent | 100 * node_memory_MemAvailable_bytes / node_memory_MemTotal_bytes |
| Nicht im Leerlauf verbrauchte CPU | 100 * (1 - avg by(instance) (rate(node_cpu_seconds_total{mode="idle"}[5m]))) |
| Ceph-OSD-Zustand | ceph_osd_up |
| Verwendete Ceph-Kapazität | ceph_cluster_used_bytes |
Metriknamen können je nach Edition und Exporterversion abweichen. Prüfen Sie die tatsächlich vorhandenen Namen über die Metriksuche.
REST API für Monitoring konfigurieren
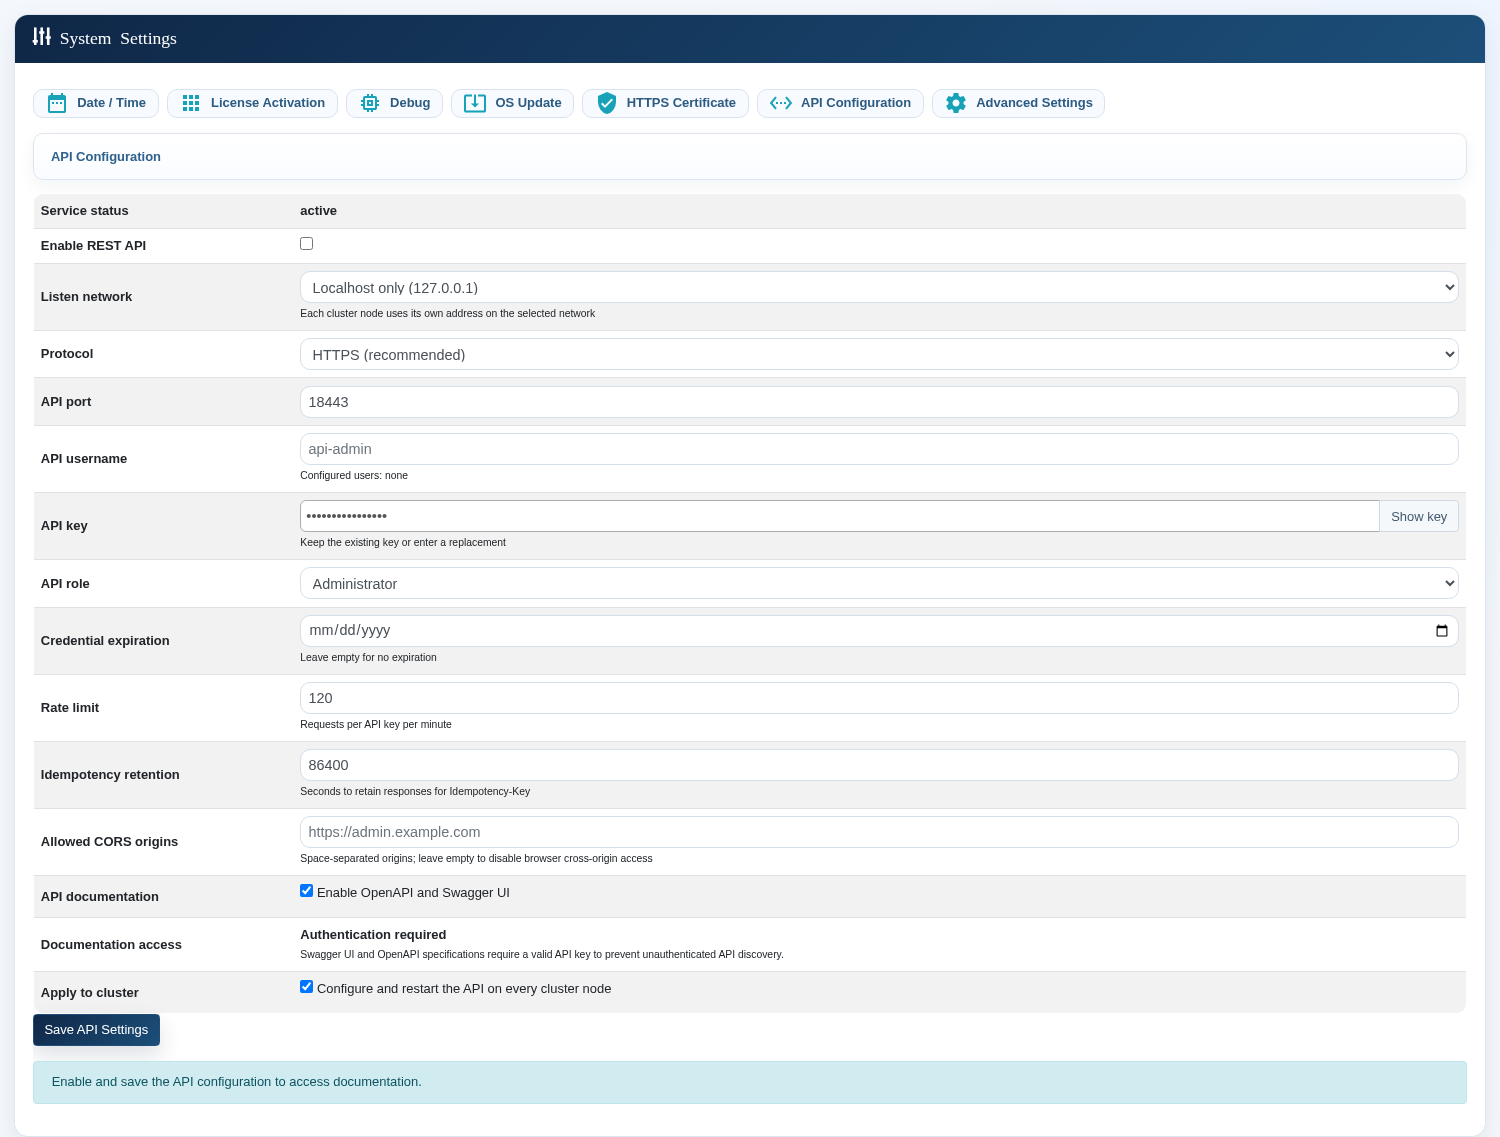
- Öffnen Sie System Settings → API Configuration.
- Aktivieren Sie den externen REST-API-Zugriff.
- Wählen Sie ein erreichbares Verwaltungsnetz. Localhost only ist extern nicht erreichbar.
- Verwenden Sie HTTPS und standardmäßig Port
18443. - Erstellen Sie einen eigenen API-Benutzer mit starkem Schlüssel und möglichst schreibgeschützter Rolle.
- Legen Sie Ablaufdatum und Rate Limit fest.
- Aktivieren Sie Swagger/OpenAPI nur bei Bedarf.
- Speichern Sie den Schlüssel in einem Secrets Manager.
Zugriff testen
export EEVOS_URL="https://<eevos-adresse>:18443"
export EEVOS_API_KEY="<api-schlüssel>"

curl --fail --silent --show-error   -H "X-API-Key: $EEVOS_API_KEY"   "$EEVOS_URL/health"
REST-Clients verwenden X-API-Key. Der GUI-Sitzungscookie ist für die REST API nicht geeignet.
| Schreibgeschützter Endpunkt | Verwendung |
|---|---|
/health |
Zustand des API-Dienstes |
/api/v1/product/capabilities |
Installierte Produktfunktionen |
/api/v1/cluster/monitor |
Zusammenfassung des Clusterzustands |
/api/v1/vms/status-quick |
Kompakte VM-Zustandsübersicht |
/api/v1/vms/with-stats |
VM-Inventar mit Laufzeitdaten |
/api/v1/jobs |
Zustand asynchroner Aufträge |
Monitoring mit Ansible
Verwenden Sie einen separaten Ansible-Control-Node. Für einen Cluster genügt normalerweise eine Manager-Adresse. Speichern Sie Passwörter und API-Schlüssel in Ansible Vault und nicht im Inventar.
ansible-playbook --syntax-check monitor-eevos.yml
ansible-playbook --check monitor-eevos.yml- Verwenden Sie Leseoperationen für regelmäßige Monitoringläufe.
- Prüfen Sie neue Playbooks zuerst mit Syntaxprüfung und Check Mode.
- Verwenden Sie pro Monitoring-System eigene Zugangsdaten.
- Begrenzen Sie Abfragehäufigkeit und Parallelität.
Alarme und Prüfintervalle
- Prüfen Sie unter Prometheus → Alerts den Regelzustand.
- Stellen Sie sicher, dass Alertmanager und Empfänger erreichbar sind.
- Trennen Sie Warnungen und kritische Meldungen, wenn unterschiedliche Reaktionen erforderlich sind.
- Senden Sie nach Einrichtung, Upgrades und Zertifikatsänderungen eine Testmeldung.
- Speichern Sie keine Zugangsdaten in Alarmtexten.
| Information | Typisches Intervall |
|---|---|
API-Zustand und Exporter up |
1–5 Minuten |
| CPU, Speicher, Datenträger und Netzwerk | 1–5 Minuten |
| VM-Laufzeitzustand | etwa 5 Minuten |
| Ceph Health, OSDs und Placement Groups | 1–5 Minuten |
| Kapazitätstrend | stündlich oder täglich |
Fehlerbehebung
| Problem | Prüfung und Maßnahme |
|---|---|
| Prometheus leitet zur Anmeldung um | Melden Sie sich zuerst an der GUI an und öffnen Sie den Proxy im selben Browser. |
Ein Target ist down |
Prüfen Sie Status → Targets, lastError, den Knoten, Exporterdienst, DNS und Firewall. |
| Dashboard enthält Lücken | Prüfen Sie Prometheus-Bereitschaft, Target-Zustand, Zeitsynchronisierung und Dienstprotokolle. |
| REST funktioniert nur lokal | Prüfen Sie Listen Network, Firewall, Routing und den externen API-Zugriff. |
| REST antwortet mit 401 oder 403 | Prüfen Sie API-Schlüssel, Rolle, Ablaufdatum und Schlüsselrotation. |
| REST antwortet mit 429 | Reduzieren Sie die Abfragehäufigkeit. |
Tägliche Checkliste
- Alle erwarteten Prometheus-Targets melden
up. - Alle Knoten liefern aktuelle Systemdaten.
- Ceph-OSDs und Placement Groups sind fehlerfrei.
- Keine unerwarteten kritischen Alarme sind offen.
- REST
/healthantwortet und Zugangsdaten laufen nicht kurzfristig ab. - Aufträge hängen nicht dauerhaft in
running. - VM- und Balancing-Zustand entsprechen den Erwartungen.
- Die Kapazität bietet Reserve für Ausfälle und Wartung.
Sicherheit
Verwenden Sie den GUI-Sitzungscookie nur für den Prometheus-Proxy und einen eigenen API-Schlüssel für REST. Beschränken Sie den Zugriff auf Verwaltungsnetze, prüfen Sie TLS-Zertifikate und wechseln Sie Zugangsdaten regelmäßig. Veröffentlichen Sie Prometheus, Exporter oder die REST API nicht direkt in nicht vertrauenswürdige Netze.